

今回の卓話
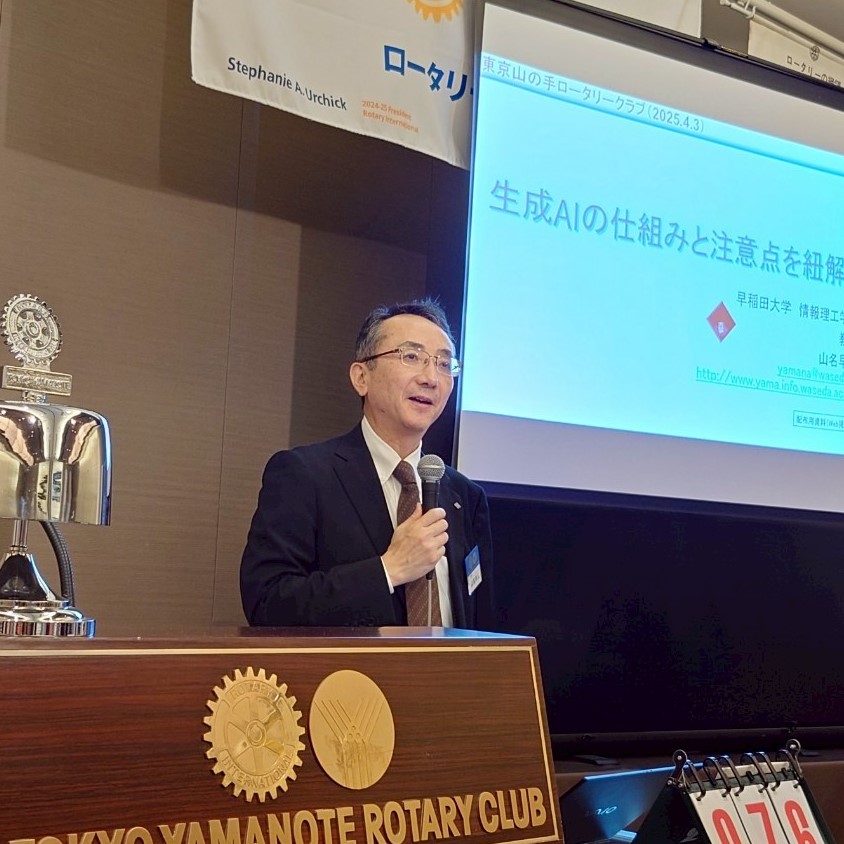
皆様、本日はお招きいただき、誠にありがとうございます。ただいまご紹介いただきました、早稲田大学の山名早人です。本日は「生成AIの仕組みと注意点を紐解く」というテーマで、最近話題の生成AIについて、その歴史から最新の動向まで、わかりやすくお話したいと思います。
まず、AIの歴史について簡単に振り返ります。AI(人工知能)という言葉は1950年代に生まれました。1950年代後半からのAI研究は、ゲームの「ハノイの塔」に代表される推論・探索手法に関するものでした。そして、1980年度に入り第2次AIブームが始まります。日本では、新世代コンピュータプロジェクトが始まり、人間が問題を解く時の考え方をコンピューターに真似させようというもので、記号処理という方法が中心でした。これは、言葉や記号を使って論理的に考えることをコンピューターにさせようとする試みです。
その後も、AI研究は何度かブームと冬の時代を繰り返します。1990年後半から2010年頃までの冬の時代を経て、2010年代には、ディープラーニングという新しい技術が登場しました。これは、人間の脳の神経回路を模倣したニューラルネットワークという仕組みを深く(ディープに)重ねることで、AIの能力を飛躍的に向上させるものです。ディープラーニングは、画像認識や音声認識といった分野で、それまでのAIでは考えられなかったほどの高い精度を実現し、第三次AIブームをもたらしました。
次に、AIと生成AIの違いについてご説明します。従来のAIは、主に「認識」や「分類」といった、与えられた情報を分析し、それが何かを判断したり、グループ分けしたりすることを得意としていました。例えば、画像を見てそれが猫であると認識したり、メールをスパムと分類したりするAIです。
これに対して、生成AIは、新たなコンテンツを「生成」することを可能にするAIです。例えば、文章生成AIは、与えられたテーマに基づいて小説や詩、レポートなどを自動的に作成することができます。画像生成AIは、テキストで指示するだけで、リアルな画像やイラストを生成することができます。つまり、生成AIは、何かを作り出すことができるAIなのです。
そして、生成AIの根幹をなす技術の一つが、大規模言語モデル(LLM)です。LLMは、膨大なテキストデータを学習することで、人間が書く文章の統計的な性質を捉え、自然な文章を生成することを可能にします。まさに、赤ちゃんが言葉を学んでいく過程と同じです。赤ちゃんは、お父さんやお母さんとの会話を通して、真似ることから言葉を学んでいきます。つまり、LLMの着想は、ある単語列が与えられたときに、次の単語が出現する確率を予測して、もっとも確からしい単語を選んで文を生成していくことにあります。こうした発想は昔からありましたが、どう実現するかが課題でした。
LLMのブレークスルーは、GoogleによってTransformerという新しい方式が提案されたこと、そして、学習するための膨大な文章が得られる時代になったことの2点にあります。特に後者はインターネットを通じて膨大なデータが公開されているが故に可能となりました。
近年、目覚ましい発展を遂げている生成AI、特にChatGPTは、まるで人間と対話しているかのような自然な応答を可能にする技術として、社会に大きなインパクトを与えています。その仕組みは、膨大なテキストデータを学習し、統計的なパターンを捉えることで、与えられた質問や指示に対して適切な文章を生成するというものです。
しかし、この技術を過信するのは禁物です。ChatGPTは、学習したデータに基づいて応答を生成するため、論理的な推論や計算が苦手な側面があります。例えば、「3.11と3.9、どちらが大きいですか?」という質問に対して、誤った答えを返してしまうことがあります。これは、AIが表面的なパターンを捉えることに長けている一方で、数値の意味や論理的な関係性を理解していないために起こります。
また、生成AIの利用には、電力消費という大きな課題も伴います。検索エンジンと比較して、1回の質問に対する電力消費量が約10倍にも達するというデータもあり、その環境負荷は決して無視できません。
一方で、生成AIの研究は日々進歩しており、その可能性は広がり続けています。最近では、人間の脳の仕組みを模倣したAI、例えば、オルガノイドAIなどの研究も進められており、より高度な処理能力や効率化が期待されています。
生成AIを有効に活用するためには、いくつかの重要な注意点があります。まず、質問や指示の具体性です。抽象的な質問では、AIも抽象的な回答しか生成できません。具体的な手順や条件を詳細に伝えることで、より精度の高い結果を得ることができます。例えば、プログラミングの例では、ゲームのルールや手順を細かく指示する必要があります。
また、生成AIは、学習データに存在しない情報を創造することはできません。そのため、生成された情報が常に正しいとは限りません。特に、未来の予測や計算結果などは、鵜呑みにせず、必ず複数の情報源を参照し、その根拠を確認することが重要です。
画像生成AIについても同様です。与えられた指示に基づいて画像を生成しますが、その内容は物理的な法則や常識に反することがあります。例えば、介護用パワースーツの画像を生成する際に、不自然な姿勢や手の位置が描かれることがあります。このような場合には、より具体的な指示や条件を追加することで、より現実に近い画像を生成することができます。
生成AIは、まだ発展途上の技術であり、人間のような常識や判断力を持っているわけではありません。しかし、適切な使い方をすれば、私たちの仕事や生活を大きく変える可能性を秘めています。
重要なのは、生成AIを過信せず、常に批判的な視点を持つことです。生成された情報を鵜呑みにせず、常に「本当か?」「なぜそうなるのか?」と問いかける姿勢が大切です。
皆様が生成AIを正しく理解し、有効に活用することで、より豊かな未来を創造できると信じています。
ご清聴ありがとうございました。


